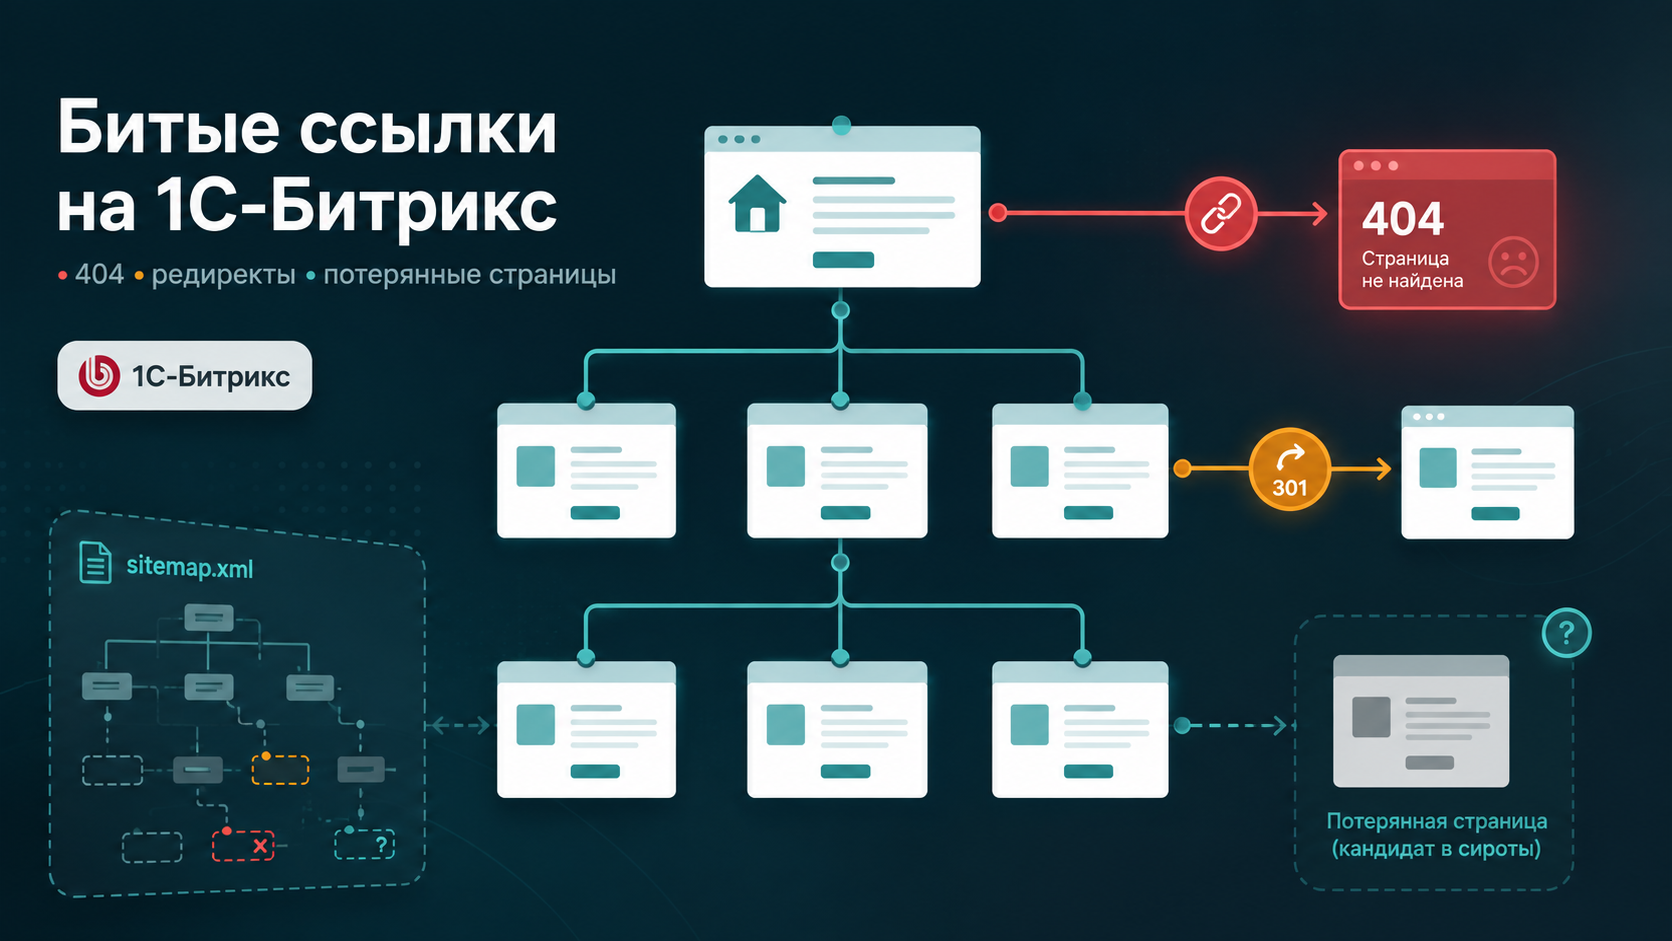
Главная страница открывается. Каталог работает. Формы отправляются. На первый взгляд с сайтом всё в порядке.
При этом внутри проекта могут годами накапливаться ссылки на старые товары, удалённые разделы, несуществующие изображения и URL, которые давно переехали на другие адреса.
Такие проблемы редко ломают сайт целиком. Пользователь замечает их только тогда, когда попадает на конкретную страницу и нажимает конкретную ссылку.
Поэтому техническое состояние сайта нельзя оценивать только вопросом «открывается ли он». Важно посмотреть ещё и на внутреннюю структуру: какие страницы связаны между собой и куда фактически ведут эти связи.
Что считать битой ссылкой
Битая внутренняя ссылка — это ссылка с действующей страницы сайта на URL или ресурс, который больше не работает так, как предполагает структура сайта.
Например, ссылка ведёт на адрес с ответом:
-
404 Not Found;
-
410 Gone;
-
5xx;
-
другой неправильный URL.
То же самое может происходить не только с HTML-страницами.
На странице могут отсутствовать:
-
изображения;
-
PDF и другие документы;
-
загружаемые файлы;
-
CSS;
-
JavaScript;
-
другие внутренние ресурсы.
Яндекс Вебмастер сейчас отдельно показывает неработающие внутренние ссылки и для каждой может указывать исходную страницу, адрес назначения и HTTP-статус 4xx или 5xx. При этом сам Яндекс предупреждает, что данные строятся по известным его роботу страницам, поэтому такой отчёт не обязательно содержит вообще все ссылки сайта.
Ссылка через 301 — не совсем битая
Представим:
страница A → старый URL B → 301 → новый URL C.
Пользователь в итоге попадает куда нужно.
Поэтому называть такую ссылку полностью неработающей было бы неточно.
Но если B уже давно не нужен, внутреннюю ссылку с A обычно разумнее обновить сразу на C.
Google при изменении URL прямо рекомендует обновлять собственные внутренние ссылки на новые адреса. Это улучшает пользовательский путь и уменьшает лишнюю нагрузку на сервер.
То есть отдельный рабочий 301 — не катастрофа. Но сотни внутренних ссылок, постоянно проходящих через старые адреса, уже выглядят как накопившийся технический долг.
Откуда появляются битые ссылки
На живом сайте это происходит естественно.
Сегодня создана страница.
Через полгода изменили структуру.
Ещё через год удалили товар или перенесли раздел.
А ссылки на старый адрес остались.
Типичные причины:
-
удалили товар, услугу или статью;
-
изменили символьный код;
-
поменяли структуру ЧПУ;
-
перенесли раздел;
-
удалили изображение или документ;
-
заменили шаблон сайта;
-
забыли старую ссылку внутри текста;
-
в меню остался прежний адрес;
-
компонент продолжает формировать устаревшие URL;
-
сторонний модуль генерирует неправильный путь;
-
сайт переносили или существенно перестраивали;
-
адрес был введён вручную с ошибкой.
На 1С-Битрикс добавляется несколько характерных мест, которые приходится проверять:
-
инфоблоки и их шаблоны URL;
-
меню;
-
шаблоны компонентов;
-
свойства элементов со ссылками;
-
собственные компоненты;
-
ЧПУ;
-
правила обработки адресов.
Сам urlrewrite.php не является причиной битых ссылок. Это один из механизмов маршрутизации 1С-Битрикс: он позволяет обрабатывать виртуальные URL и направлять их нужному скрипту или компоненту. Но после изменения структуры сайта правила маршрутизации и формирование ссылок должны оставаться согласованными.
Почему проверка главной страницы почти ничего не говорит о ссылках
Представим сайт с несколькими сотнями товаров и десятками статей.
Владелец проверяет:
-
главную;
-
каталог;
-
контакты;
-
форму заявки.
Всё работает.
Но на статье трёхлетней давности стоит ссылка на удалённую услугу.
В карточке товара отсутствует старая инструкция PDF.
В другом разделе шаблон формирует ссылку на прежний URL.
В меню старого подраздела остался адрес, который теперь проходит через два redirects.
Такой сайт может визуально казаться полностью рабочим.
Проблема обнаружится только при попадании на конкретный маршрут — либо при системном обходе внутренних ссылок.
Именно поэтому для диагностики полезнее обходить сайт как структуру, а не проверять несколько выбранных страниц вручную.
Зачем внутренние ссылки поисковому роботу
Внутренняя ссылка нужна не только человеку.
Google прямо говорит, что использует ссылки для обнаружения новых страниц и рекомендует, чтобы каждая важная страница имела ссылку хотя бы с одной другой страницы сайта.
Яндекс также описывает внутренние и внешние ссылки как один из способов, которыми индексирующий робот узнаёт о страницах сайта.
Из этого не следует:
«нашли одну битую ссылку — позиции сайта упадут».
Такой зависимости официальная документация не устанавливает.
Практическая проблема проще.
Если реальная структура содержит неправильные связи, людям и роботам сложнее последовательно перемещаться по сайту.
Например, важная страница существует, но ссылки на неё удалены.
Или раздел продолжает ссылаться на десятки уже несуществующих карточек.
Тогда вопрос уже не в одной ошибке, а в качестве всей структуры.
Лишние редиректы
Редирект сам по себе — нормальный инструмент.
Если адрес изменился:
старый URL → 301 → новый URL
— это штатная ситуация.
Google и Яндекс распознают постоянные и временные HTTP-redirects.
Но после переноса полезно отдельно проверить внутренние ссылки.
Одиночный 301
Страница A по-прежнему ссылается на старый B, а B перенаправляет на C.
Пользователь обычно даже не заметит проблему.
Если таких ссылок немного, это не повод объявлять сайт технически неисправным.
Но если новый адрес C уже известен, внутреннюю ссылку чаще разумнее изменить сразу на него.
Цепочка редиректов
Хуже выглядит ситуация:
A → B → C → D.
Google отдельно рекомендует избегать цепочек redirects: они добавляют задержку и ухудшают эффективность обхода. В документации по миграциям Google советует по возможности направлять сразу на конечный URL.
Например, после нескольких реконструкций сайта может сохраниться история:
старый товар → старый раздел → новый раздел → новая карточка.
Для пользователя всё ещё «работает», но структуру лучше привести в порядок.
Цикл редиректов
Ещё один вариант:
A → B → C → A.
Здесь пользователь уже не получает нормальную конечную страницу.
Такие ситуации нужно отличать от обычного рабочего 301 и исправлять как ошибку маршрутизации.
Битые изображения и другие ресурсы
При проверке ссылок легко ограничиться только переходами между HTML-страницами.
Но сама страница может отвечать 200 OK и выглядеть сломанной внутри.
Например:
-
отсутствует фотография товара;
-
удалён файл инструкции;
-
статья ссылается на старый PDF;
-
шаблон пытается загрузить несуществующий ресурс.
Google при планировании переносов сайта отдельно рекомендует учитывать не только HTML-URL, но также изображения, видео, JavaScript и CSS.
Для обычной проверки сайта это полезный принцип: состояние страницы — это не только HTTP-код самого документа.
При этом нет необходимости превращать каждую проверку битых ссылок в полноценный аудит frontend-производительности. Задача здесь проще: обнаружить ресурсы, на которые действующий сайт ссылается, хотя их больше нет.
Что такое orphan page
В технических аудитах используется термин orphan page — страница-сирота.
Упрощённо это URL, который существует, но на него не находится нормальных входящих внутренних ссылок из доступной структуры сайта.
Например:
элемент инфоблока существует;
URL отвечает 200;
страница даже находится в sitemap.xml;
но с других публичных страниц сайта на неё никто не ссылается.
Поисковая система всё ещё может узнать такой URL из Sitemap, внешней ссылки или прошлых обходов.
Но с точки зрения внутренней архитектуры страница выпала из структуры.
Почему лучше говорить «кандидат в orphan pages»
Один автоматический обход не всегда может доказать, что у URL вообще нет входящих ссылок.
Например:
-
ссылка формируется только для авторизованного пользователя;
-
часть структуры не была доступна обходчику;
-
ссылка появляется через JavaScript;
-
существует альтернативный маршрут;
-
инструмент ещё не исследовал весь сайт.
Поэтому в диагностике я предпочитаю формулировку:
«кандидат в orphan pages».
Дальше такой URL нужно проверять вручную и понимать его назначение.
Откуда появляются потерянные страницы
Частые сценарии:
-
страницу убрали из меню, но не удалили;
-
поменяли разделы каталога;
-
после редизайна забыли вернуть ссылку;
-
публикация осталась только в Sitemap;
-
элемент существует в инфоблоке, но компонент больше не выводит путь к нему;
-
старый раздел перестал участвовать в навигации;
-
изменилась логика внутренних ссылок.
И здесь возникает важный вопрос:
эта страница действительно потеряна случайно или она больше вообще не должна быть частью публичного сайта?
Не каждый найденный URL нужно немедленно возвращать в меню.
Почему одного sitemap.xml недостаточно
Sitemap полезен.
Но это не полная модель внутренней структуры.
Google прямо пишет: если страницы сайта хорошо связаны между собой, Google обычно может обнаружить большую часть сайта через навигацию и ссылки. Sitemap дополняет этот процесс, особенно для крупных и сложных сайтов, но не заменяет нормальные внутренние связи.
Яндекс также указывает, что Sitemap сообщает роботу о текущей структуре, но не гарантирует появление всех содержащихся в нём URL в поиске. Робот использует и другие способы обнаружения, включая ссылки между страницами.
На 1С-Битрикс sitemap.xml может генерироваться штатным механизмом, где отдельно настраиваются файлы, разделы и элементы инфоблоков. Автогенерация может обновлять карту при изменении данных.
Но даже автоматически созданный Sitemap полезно сверять с живым сайтом.
Что может показать сравнение Sitemap и реального обхода
Само расхождение ещё не обязательно означает ошибку.
Но оно помогает задать правильные вопросы.
URL есть только в Sitemap
Возможные причины:
-
потеряна внутренняя ссылка;
-
страница больше не участвует в структуре;
-
Sitemap устарел;
-
URL должен обнаруживаться иным способом.
Это кандидат на ручную проверку.
URL найден при обходе, но отсутствует в Sitemap
Возможно:
-
страница не должна находиться в Sitemap;
-
генератор настроен не на весь раздел;
-
файл устарел;
-
URL технический и его отсутствие вполне ожидаемо.
Не каждую публичную ссылку обязательно нужно добавлять в Sitemap.
URL в Sitemap отвечает 404
Здесь карта сайта уже явно не соответствует текущему состоянию этого адреса.
Google рекомендует включать в Sitemap URL, которые владелец действительно хочет видеть в поиске.
Яндекс описывает Sitemap именно как источник информации об актуальной структуре сайта.
Sitemap содержит старый URL с redirect
Redirect может быть настроен правильно, но сам Sitemap обычно имеет смысл обновить до актуальной конечной версии.
В Яндекс Вебмастере для Sitemap даже предусмотрен отдельный статус «Редирект» с рекомендацией убрать перенаправление из файла и обновить адрес.
Глубина страницы
Кроме наличия ссылки важно посмотреть, насколько далеко страница находится от основных точек входа.
Например:
главная → каталог → раздел → подраздел → ещё один подраздел → страница.
Большая глубина сама по себе не является доказательством ошибки.
Не существует универсального официального правила:
«все страницы должны быть максимум в трёх кликах».
Поэтому глубину полезнее воспринимать как диагностический показатель.
Если коммерчески важная страница находится очень глубоко, стоит спросить:
-
соответствует ли это реальной структуре;
-
удобно ли пользователю её находить;
-
не потерялась ли она после перестройки разделов;
-
есть ли более логичные внутренние связи.
Для служебной или редко используемой страницы та же глубина может быть совершенно нормальной.
Почему список URL показывает не всё
Представим два отчёта.
Первый:
-
/ -
/catalog/ -
/catalog/product-1/ -
/services/ -
/contacts/
Он показывает, какие URL найдены.
Но почти ничего не говорит о структуре.
Теперь представим связи:
главная → каталог;
каталог → product-1;
product-1 → старая инструкция 404;
главная → услуги;
услуги → старый URL → 301 → новый URL;
contacts существует, но входящих ссылок при обходе не найдено.
Это уже гораздо полезнее.
Поэтому при технической диагностике структура сайта для меня — не просто список URL, а сеть связей между ними.
Не нужна сложная теория графов.
Достаточно ответить на вопросы:
-
кто ссылается на страницу;
-
куда ссылается сама страница;
-
какой HTTP-ответ получает каждый переход;
-
есть ли страницы без обнаруженных входящих ссылок;
-
насколько глубоко находится URL;
-
совпадает ли живая структура с Sitemap.
Как этот принцип используется в SEOCoder Healthcheck
При разработке собственного read-only модуля технической диагностики SEOCoder Healthcheck 1.0.0 структуру сайта я решил строить прежде всего по реальному обходу внутренних ссылок.
robots.txt и sitemap.xml при этом используются как дополнительные источники для сверки, а не как единственная «карта сайта».
Так можно анализировать не только наличие URL, но и связи между ними.
В текущей версии диагностический слой позволяет выявлять битые ссылки и ресурсы, redirects, глубину страниц, кандидатов в orphan pages и расхождения между живой структурой и Sitemap. Для этого же используется внутренняя «Карта состояния сайта», а связанные факты можно сопоставлять между разными проверками.
Например:
URL есть в Sitemap;
входящих внутренних ссылок при обходе не найдено;
дополнительно обнаруживаются связанные сигналы.
Это ещё не автоматический диагноз «страница-сирота», а основание проверить страницу внимательнее.
Модуль работает только на чтение и сам ничего на сайте не исправляет. Его задача — собрать и первично систематизировать технические данные.
Что владелец сайта может проверить самостоятельно
На небольшом сайте часть проблем реально найти без специальных инструментов.
Я бы начал с простого.
Основные меню
Пройти основные пункты и убедиться, что они ведут на ожидаемые страницы.
Старые публикации
Открыть несколько материалов, опубликованных до крупных изменений структуры.
Именно там часто остаются старые ссылки.
Недавно изменённые разделы
Если каталог или услуги переносились, проверить ссылки из соседних страниц и меню.
Карточки
Открыть несколько товаров или услуг и проверить:
-
изображения;
-
документы;
-
связанные товары;
-
кнопки;
-
дополнительные ссылки.
Redirects
Если переход визуально работает, проверить, не идёт ли он через старый URL и соответствует ли конечная страница ожиданиям.
Sitemap
Посмотреть, нет ли там явно удалённых или прежних адресов.
Такой ручной контроль полезен.
Но на сайте с сотнями или тысячами страниц невозможно надёжно открыть каждую страницу и каждую внутреннюю ссылку вручную.
Там нужен автоматический обход с последующим разбором результатов.
Практический алгоритм системной проверки
Для технической диагностики я бы использовал такую последовательность.
-
Получить исходный набор доступных страниц.
-
Начать обход внутренних ссылок с публичной структуры сайта.
-
Для каждого найденного назначения зафиксировать фактический HTTP-ответ.
-
Отдельно собрать URL с 404, 410 и 5xx.
-
Найти внутренние ссылки, ведущие через redirects.
-
Для redirects определить конечный URL и выявить цепочки или циклы.
-
Проверить связанные внутренние ресурсы: прежде всего изображения и документы, а при необходимости CSS и JavaScript.
-
Посчитать обнаруженные входящие внутренние ссылки для страниц.
-
Сформировать кандидатов в orphan pages, но не считать их автоматически подтверждёнными сиротами.
-
Сравнить полученную структуру с sitemap.xml.
-
Отдельно проверить важные и спорные страницы вручную.
-
После исправлений повторить обход и сравнить результат.
Последний этап важен.
Исправление одной ссылки может изменить маршрут обхода и открыть часть структуры, которая раньше вообще не была обнаружена.
Что делать с найденной проблемой
Здесь тоже нет правила «везде ставим redirect».
Ссылка просто неправильная
Например, в тексте опечатка:
/catalog/produt/
вместо:
/catalog/product/
Исправляется сама ссылка.
Страница действительно переехала
Старый URL больше не используется, есть полноценный новый.
Тогда может быть нужен permanent redirect, а внутренние ссылки желательно обновить сразу на конечный адрес. Google прямо рекомендует при миграциях менять собственные ссылки на новые URL.
Ресурс удалён и замены нет
Корректный 404 или 410 может быть абсолютно нормальным состоянием самого удалённого URL.
Но действующие страницы сайта не должны продолжать ссылаться на него без причины.
Страница существует, но потерялась в структуре
Тут нельзя автоматически «добавить ссылку куда-нибудь».
Сначала нужно решить:
-
страница вообще нужна;
-
должна ли оставаться публичной;
-
должна ли индексироваться;
-
где логично разместить связь с ней.
После этого уже меняется навигация или архитектура.
Типичные ошибки
-
Удалить страницу, но оставить внутренние ссылки на неё.
-
Настроить 301 и годами не обновлять собственные ссылки.
-
Считать sitemap.xml полной картой живого сайта.
-
Проверять только HTML и забывать про изображения и документы.
-
Любой URL без найденной входящей ссылки автоматически объявлять orphan page.
-
Исправлять битые ссылки по одной только после жалоб пользователей.
-
Проверять только главную и несколько основных разделов.
-
Строить технический аудит как список URL без анализа связей между ними.
Сайт — это не просто набор страниц
Отдельная страница может быть технически совершенно исправна:
200 OK;
правильный title;
нормальный текст;
корректный canonical.
Но если на неё невозможно нормально попасть из структуры сайта, перед нами уже другой тип проблемы.
И наоборот: действующая страница может содержать пять ссылок на то, чего больше не существует.
Поэтому при технической диагностике полезно задавать два разных вопроса:
«Какие страницы есть на сайте?»
и
«Как эти страницы связаны между собой и куда реально ведут их ссылки?»
Только второй вопрос позволяет увидеть внутреннюю структуру сайта, которую невозможно оценить по одной исправно работающей главной странице.