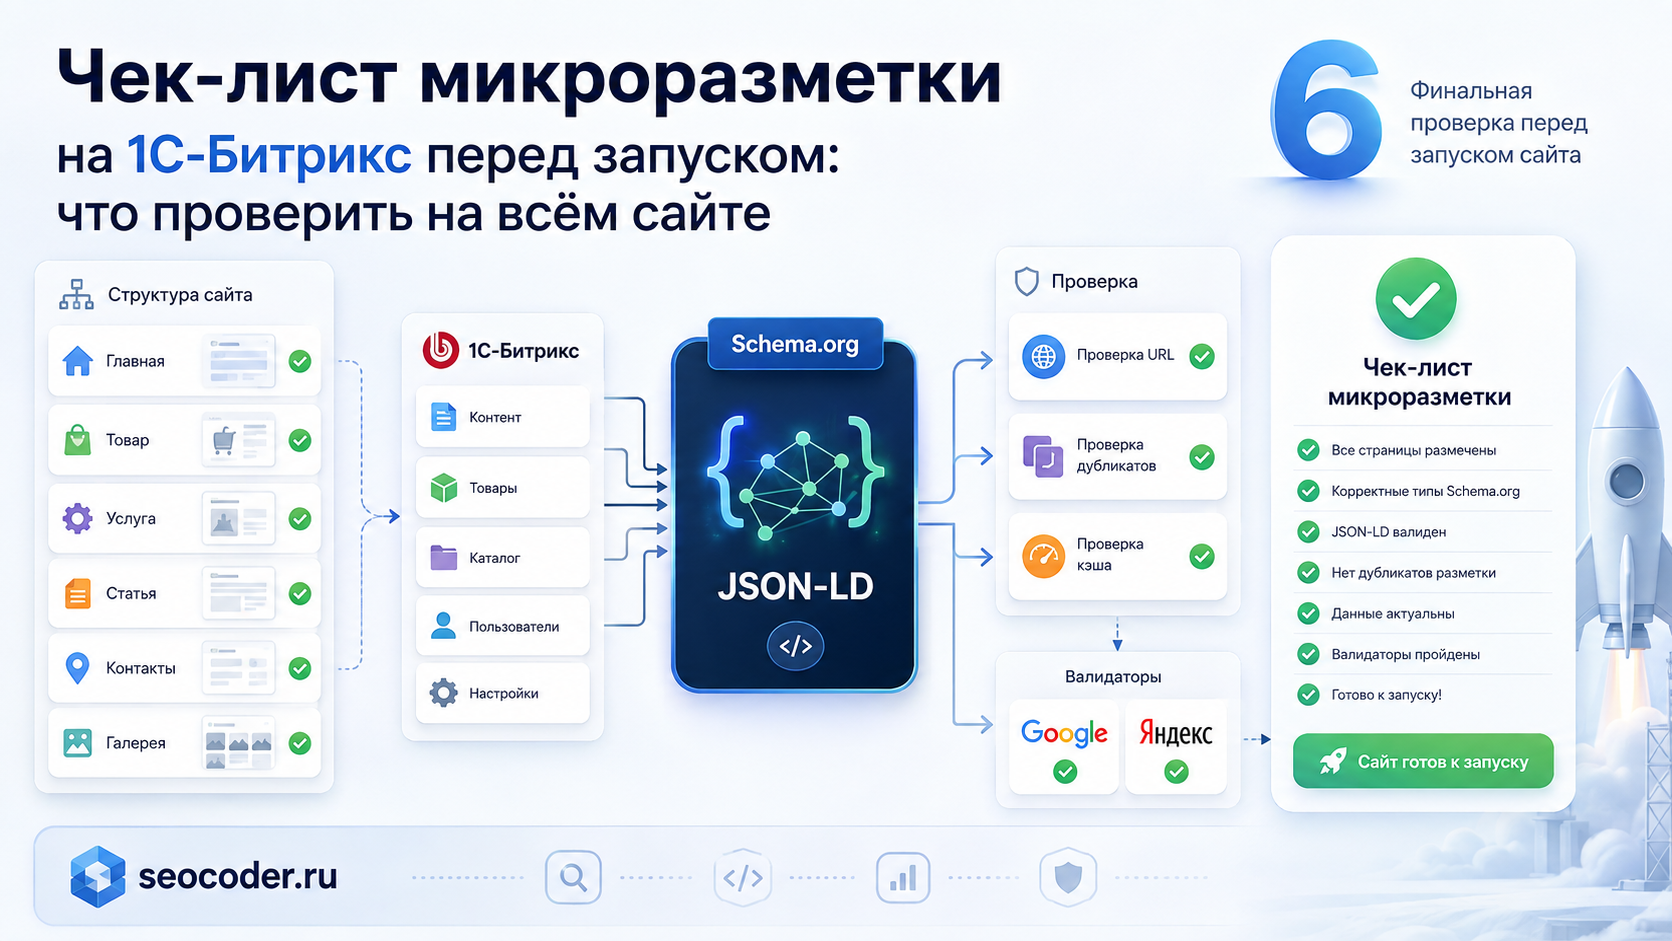
Это шестая и завершающая статья серии о микроразметке на сайтах 1С-Битрикс.
В предыдущих материалах мы отдельно разбирали выбор Schema.org, ограничения валидаторов, динамическое формирование JSON-LD и типичные ошибки реализации. Перед запуском проекта все эти части нужно собрать в одну проверку.
Главная задача на этом этапе — не убедиться, что один JSON-LD проходит один валидатор. Нужно проверить всю систему формирования структурированных данных: какие страницы существуют на сайте, какие сущности на них создаются, откуда берутся значения, что происходит с разными элементами инфоблока, как ведёт себя кеш и какую версию страницы в итоге получают поисковые системы.
1. Сначала составить карту типов страниц
Начинать проверку удобнее не с кода, а со структуры сайта.
На реальном проекте могут существовать:
-
главная страница;
-
разделы каталога;
-
карточки товаров;
-
разделы услуг;
-
страницы отдельных услуг;
-
статьи;
-
контакты;
-
фотогалереи;
-
страницы проектов;
-
информационные разделы;
-
другие шаблоны, характерные именно для этого сайта.
Для каждого типа страницы стоит заранее определить:
-
какой шаблон или компонент отвечает за вывод;
-
какая сущность является основной;
-
какие дополнительные сущности могут присутствовать;
-
откуда берутся их данные;
-
какие URL будут использованы для проверки.
Не нужно пытаться разместить на каждой странице одинаковый набор Schema.org. Тип структурированных данных должен соответствовать реальному назначению страницы.
Google в актуальных рекомендациях советует выбирать наиболее конкретный подходящий тип и следить, чтобы основная структурированная сущность отражала основной смысл самой страницы.
Практически удобно получить небольшую матрицу:
«тип страницы → шаблон → основная Schema.org-сущность → дополнительные сущности → тестовые URL».
После этого становится понятно, что именно предстоит проверять.
2. Проверить источники данных в 1С-Битрикс
Следующий уровень — не готовый JSON-LD, а данные, из которых он формируется.
Если микроразметка динамическая, для каждого важного поля нужно понимать его источник.
Например:
-
название — название элемента, отдельное SEO-свойство или другое поле;
-
описание — анонс, детальное описание или специально заведённое свойство;
-
изображение — детальная картинка, анонс-картинка или другое изображение;
-
цена — данные каталога или собственное свойство проекта;
-
наличие — данные торгового предложения или отдельная бизнес-логика;
-
URL — результат работы компонента, шаблона ЧПУ или явно построенный адрес.
Здесь важен не конкретный набор полей, а сама связь:
данные 1С-Битрикс → подготовка данных → JSON-LD.
Что происходит с пустыми значениями
Нужно проверить, что происходит, если свойство не заполнено.
Нормальный вариант зависит от конкретной сущности и требований поискового сервиса:
-
необязательное поле может вообще не попадать в JSON-LD;
-
для некоторых данных допустим осмысленный резервный источник;
-
обязательное для выбранного сценария поле должно быть реально получено, иначе разметку нельзя считать завершённой.
Опасный вариант — автоматически подставлять фиктивную цену, изображение-заглушку, тестовое описание или другое значение только для того, чтобы валидатор перестал показывать ошибку.
Отдельно важно различать Schema.org как словарь и требования конкретного поискового сервиса. Google для поддерживаемых поисковых возможностей определяет собственный набор обязательных и рекомендуемых свойств. У Яндекса для отдельных сценариев также существуют дополнительные требования. Поэтому универсального списка «обязательных полей Schema.org для всех поисковиков» нет.
Обновляются ли данные автоматически
Если изменить:
-
название элемента;
-
цену;
-
картинку;
-
описание;
-
предложение;
нужно проверить, изменится ли после этого и структурированная версия данных.
Микроразметка не должна превращаться во второй независимый каталог, который приходится редактировать вручную.
3. Проверить формирование JSON-LD
Если используется JSON-LD, проверять нужно не только набор свойств, но и способ его создания.
Google продолжает поддерживать JSON-LD, Microdata и RDFa, при этом JSON-LD остаётся рекомендуемым форматом в документации Google Search.
Для PHP-проекта безопаснее сначала сформировать массив данных, а затем сериализовать его штатными средствами PHP, чем собирать JSON длинной строкой вручную.
Особенно это заметно на реальных данных.
Нужно проверить элементы, в которых встречаются:
-
кавычки;
-
апострофы;
-
амперсанды;
-
переносы строк;
-
специальные символы;
-
длинные названия;
-
текст с HTML;
-
несколько изображений или предложений.
На идеально заполненном тестовом товаре вручную собранная JSON-строка может выглядеть нормально, а на другом элементе сломаться из-за одной кавычки.
Также нужно убедиться, что в итоговую структуру не попадают бессмысленные конструкции вроде пустой цены, пустого URL или пустого объекта изображения там, где ожидаются реальные данные.
4. Проверить URL и идентификаторы
URL — одна из областей, где ошибка может незаметно распространяться сразу на множество страниц.
Проверить стоит отдельно:
-
домен;
-
HTTPS;
-
URL текущей страницы;
-
URL товара или услуги;
-
URL изображений;
-
ссылки в BreadcrumbList;
-
значения @id;
-
canonical;
-
старые адреса;
-
тестовые домены;
-
адреса временной версии сайта.
В JSON-LD лучше использовать однозначные полноценные URL там, где свойство описывает интернет-адрес.
Особенно внимательно стоит смотреть BreadcrumbList. Для элементов хлебных крошек Google ожидает URL соответствующей страницы либо Thing с идентификатором страницы.
Для Product и Offer также нужно проверить ссылки, которые формирует конкретная реализация. В актуальных примерах Google для Offer.url используется адрес соответствующего товара.
Не путать @id с ещё одним произвольным URL
В JSON-LD @id используется как идентификатор сущности. Schema.org также рассматривает @id как встроенный способ URI-идентификации объекта.
Поэтому важно не просто механически вставить туда текущий адрес страницы, а понимать, какую сущность идентификатор обозначает.
Если одна и та же Organization используется на разных страницах сайта, её идентификатор должен оставаться логически стабильным, а не превращаться в новую организацию на каждом URL.
Сравнить с canonical и фактической страницей
Нужно посмотреть одновременно:
-
какой URL открыт в браузере;
-
какой canonical отдаёт страница;
-
какие URL записаны в JSON-LD;
-
куда ведут хлебные крошки.
Это быстро обнаруживает остатки тестового домена, HTTP вместо HTTPS, неправильные ЧПУ и ссылки на старую структуру сайта.
5. Сверить разметку с тем, что видит пользователь
Это одна из главных проверок перед запуском.
Если в структурированных данных указана цена, нужно открыть страницу и сравнить её с видимой ценой.
То же самое относится к:
-
наличию;
-
названию;
-
описанию;
-
изображениям;
-
рейтингу;
-
количеству отзывов;
-
характеристикам;
-
данным организации;
-
другим значимым значениям.
Google прямо требует, чтобы структурированные данные описывали содержимое соответствующей страницы, не были вводящими в заблуждение и не размечали информацию, скрытую от пользователя. Данные также должны оставаться актуальными.
Поэтому наличие корректного JSON само по себе ничего не доказывает. Нужно сравнивать его с самой страницей.
Особенно опасны здесь резервные значения. Например, если цена отсутствует в 1С-Битрикс, не стоит автоматически отправлять поисковой системе какое-либо условное число только ради заполнения свойства.
6. Найти старую и дублирующую микроразметку
После внедрения нового решения я обычно отдельно проверяю исходный HTML страницы на наличие другой разметки.
Она может остаться:
-
в старом шаблоне сайта;
-
в шаблоне компонента;
-
в подключаемом PHP-файле;
-
в установленном модуле;
-
в SEO-модуле;
-
в готовом решении;
-
в старой доработке;
-
в другом JSON-LD в head или body.
Сам факт нескольких Schema.org-сущностей на странице не является ошибкой. На странице вполне могут одновременно существовать, например, основная сущность, BreadcrumbList и связанные объекты.
Проблема начинается, когда параллельно формируются две версии одной и той же сущности с разными данными.
Например:
-
два Product с разной ценой;
-
две Organization с разными телефонами;
-
два BreadcrumbList с разными URL;
-
старая и новая разметка услуги одновременно.
Искать такие ситуации лучше не только глазами в шаблоне, но и по конечному HTML, который реально отдал сервер.
7. Отдельно проверить кеш 1С-Битрикс
Проверка без кеша недостаточна для сайта на 1С-Битрикс.
Документация 1С-Битрикс прямо указывает, что компоненты могут работать с автокешированием, а обновление информации зависит от настроек конкретного компонента и выбранного режима кеширования.
Поэтому для репрезентативной страницы полезно провести как минимум два сценария.
После очистки кеша
Открыть страницу и проверить:
-
присутствует ли JSON-LD;
-
все ли данные актуальны;
-
соответствует ли он текущему элементу;
-
нет ли ошибок.
Повторный запрос из кеша
Снова открыть страницу и проверить то же самое.
JSON-LD не должен:
-
исчезнуть;
-
превратиться в структуру другого элемента;
-
вернуть старую цену;
-
потерять часть динамических данных;
-
сформироваться иначе только потому, что компонент теперь работает из кеша.
Учитывать место формирования данных
Если реализация связана с шаблоном компонента, result_modifier.php или component_epilog.php, нужно учитывать их место в жизненном цикле компонента.
В официальной документации 1С-Битрикс result_modifier.php описан как файл обработки результата перед подключением шаблона, при этом его работа связана с кешированием результата. component_epilog.php выполняется после шаблона и используется в том числе для задач, которым необходимо работать при включённом кешировании.
Это не означает, что микроразметку обязательно нужно размещать в каком-то одном из этих файлов. Реализация зависит от проекта.
Но это означает, что проверять только первый запрос после очистки кеша нельзя.
8. Проверить разные данные одного шаблона
Ещё одна распространённая ошибка — взять идеальный товар или услугу, полностью заполнить все свойства и проверить только эту страницу.
Такой тест показывает лучший сценарий, а не устойчивость реализации.
Для одного шаблона лучше взять несколько реальных элементов.
Например:
-
полностью заполненный;
-
без одного необязательного свойства;
-
с необычным или длинным названием;
-
с отсутствующим дополнительным изображением;
-
с несколькими предложениями;
-
с несколькими ценами, если проект действительно поддерживает такой сценарий;
-
с другими крайними вариантами, которые реально встречаются в данных сайта.
Задача здесь не в искусственном создании десятков тестов.
Нужно убедиться, что код корректно работает не только с тем элементом, на котором его разрабатывали.
9. Проверить каждый тип страницы
После проверки разных данных остаётся ещё один уровень — разные шаблоны.
Если на сайте есть:
-
главная;
-
товары;
-
услуги;
-
контакты;
-
статьи;
-
разделы;
-
галереи;
проверка одной карточки товара ничего не говорит о контактах или информационном разделе.
Поэтому перед сдачей работы стоит выбрать минимум по одному репрезентативному URL каждого реального типа страницы.
Для сложных типов страниц разумно проверить несколько URL.
Именно этот этап превращает проверку отдельного JSON-LD в проверку системы.
10. Использовать валидаторы по назначению
Ни один инструмент не отвечает сразу на все вопросы.
Schema Markup Validator
Schema Markup Validator нужен прежде всего для проверки того, как структурированные данные соответствуют словарю Schema.org и как они разбираются.
Это полезная базовая проверка, но она не отвечает на вопрос, получит ли страница расширенное представление конкретно в Google или Яндексе.
Google Rich Results Test
Rich Results Test ориентирован на структурированные данные и расширенные результаты, которые поддерживает Google.
Поэтому ситуация, когда Schema.org-сущность существует и корректна, но не даёт отдельного результата в Rich Results Test, сама по себе ещё не означает, что Schema.org-разметка неправильная.
Google отдельно предупреждает: даже корректная разметка, прошедшая Rich Results Test, не гарантирует показ расширенного результата в поиске.
Яндекс Валидатор микроразметки
Валидатор Яндекс Вебмастера проверяет, распознаёт ли Яндекс семантическую разметку страницы. Сейчас он поддерживает в том числе Schema.org и Open Graph и дополнительно учитывает требования сервисов Яндекса.
Поэтому результат Яндекса полезно проверять отдельно от Google.
Google Search Console и URL Inspection
После публикации нужен уже не только тест вставленного кода.
URL Inspection позволяет проверить, как Google получает страницу, выполнить проверку живого URL и при необходимости запросить повторное сканирование отдельных страниц. Google рекомендует использовать этот инструмент после публикации структурированных данных и новых шаблонов.
Яндекс Вебмастер
В Яндекс Вебмастере после публикации имеет смысл следить уже не только за валидатором, но и за состоянием сайта и индексированием страниц.
В сервисе доступны диагностика сайта и мониторинг важных страниц, позволяющий отслеживать информацию об их индексировании.
Именно поэтому один зелёный результат одного валидатора — это только один этап проверки, а не знак «работа закончена».
Практика: как проверялся недавний проект на 1С-Битрикс
В недавнем проекте внедрения микроразметки на 1С-Битрикс для проверки использовались восемь репрезентативных URL разных типов.
Страницы проверялись инструментами Google и Яндекса.
В зависимости от назначения страницы использовались разные сущности, в том числе:
-
WebSite;
-
ProfessionalService;
-
Service;
-
Product;
-
AggregateOffer;
-
ContactPage;
-
CollectionPage;
-
ItemList;
-
ImageGallery;
-
ImageObject;
-
BreadcrumbList;
-
разметка информационных материалов.
Данные для микроразметки формировались динамически из 1С-Битрикс.
При проверке отдельно обращалось внимание на:
-
BreadcrumbList;
-
абсолютные URL;
-
Product.url;
-
Open Graph;
-
различия между шаблонами страниц;
-
работу реализации при кешировании.
Для меня это хороший пример того, почему при сдаче подобной работы недостаточно открыть одну страницу и проверить один JSON-LD.
Нужно пройти по типам страниц и посмотреть систему целиком.
11. После публикации проверка не заканчивается
Локальный тест показывает, что код работает сейчас.
Поисковая система увидит новую версию только после следующего сканирования страницы.
Google прямо рекомендует после внедрения структурированных данных проверить опубликованные URL, а затем следить за соответствующими отчётами Search Console. Повторное сканирование и индексирование происходят не мгновенно, а запрос на переобход сам по себе не гарантирует моментального изменения поисковой выдачи.
У Яндекса обработка микроразметки также связана с обходом страницы роботом и последующей обработкой данных.
После запуска стоит:
-
проверить опубликованную страницу ещё раз;
-
убедиться, что роботам доступна актуальная версия;
-
проверить состояние индексирования;
-
следить за сообщениями и отчётами Search Console;
-
следить за Яндекс Вебмастером;
-
повторять проверку после заметных изменений шаблонов.
И главное — не обещать заказчику или владельцу сайта конкретный rich result только потому, что разметка реализована правильно.
Google официально не гарантирует расширенный результат даже для технически корректной структурированной разметки.
Финальный чек-лист микроразметки перед запуском
Перед сдачей проекта я бы прошёл по этому списку:
-
Составлены все реальные типы страниц сайта.
-
Для каждого типа определена основная Schema.org-сущность.
-
Выбраны репрезентативные URL каждого шаблона.
-
Понятен источник каждого важного динамического значения в 1С-Битрикс.
-
Проверено поведение при пустых необязательных свойствах.
-
В разметку не подставляются фиктивные тестовые данные.
-
JSON-LD корректно кодируется, а не собирается небезопасной строкой.
-
Проверены кавычки, специальные символы и необычные значения.
-
Все URL относятся к актуальному домену и HTTPS.
-
Проверены URL изображений, Product.url и BreadcrumbList.
-
Проверены @id и логика идентификации сущностей.
-
URL в разметке сопоставлены с фактическим адресом страницы и canonical.
-
Цена, наличие, название, изображения и другие данные сверены с видимым содержимым.
-
В конечном HTML нет конфликтующей старой или дублирующей микроразметки.
-
Страница проверена после очистки кеша 1С-Битрикс.
-
Та же страница повторно проверена уже при работе из кеша.
-
Проверено несколько элементов одного шаблона с разными реальными данными.
-
Проверены все основные шаблоны, а не одна «идеальная» страница.
-
Результаты сверены несколькими подходящими инструментами Google, Schema.org и Яндекса.
-
После публикации проверены доступность страниц для роботов и состояние индексирования.
Если все эти пункты пройдены, можно говорить не о том, что «валидатор зелёный», а о том, что система формирования структурированных данных на сайте действительно проверена.
Именно такую проверку я считаю нормальным финальным этапом внедрения микроразметки на 1С-Битрикс.