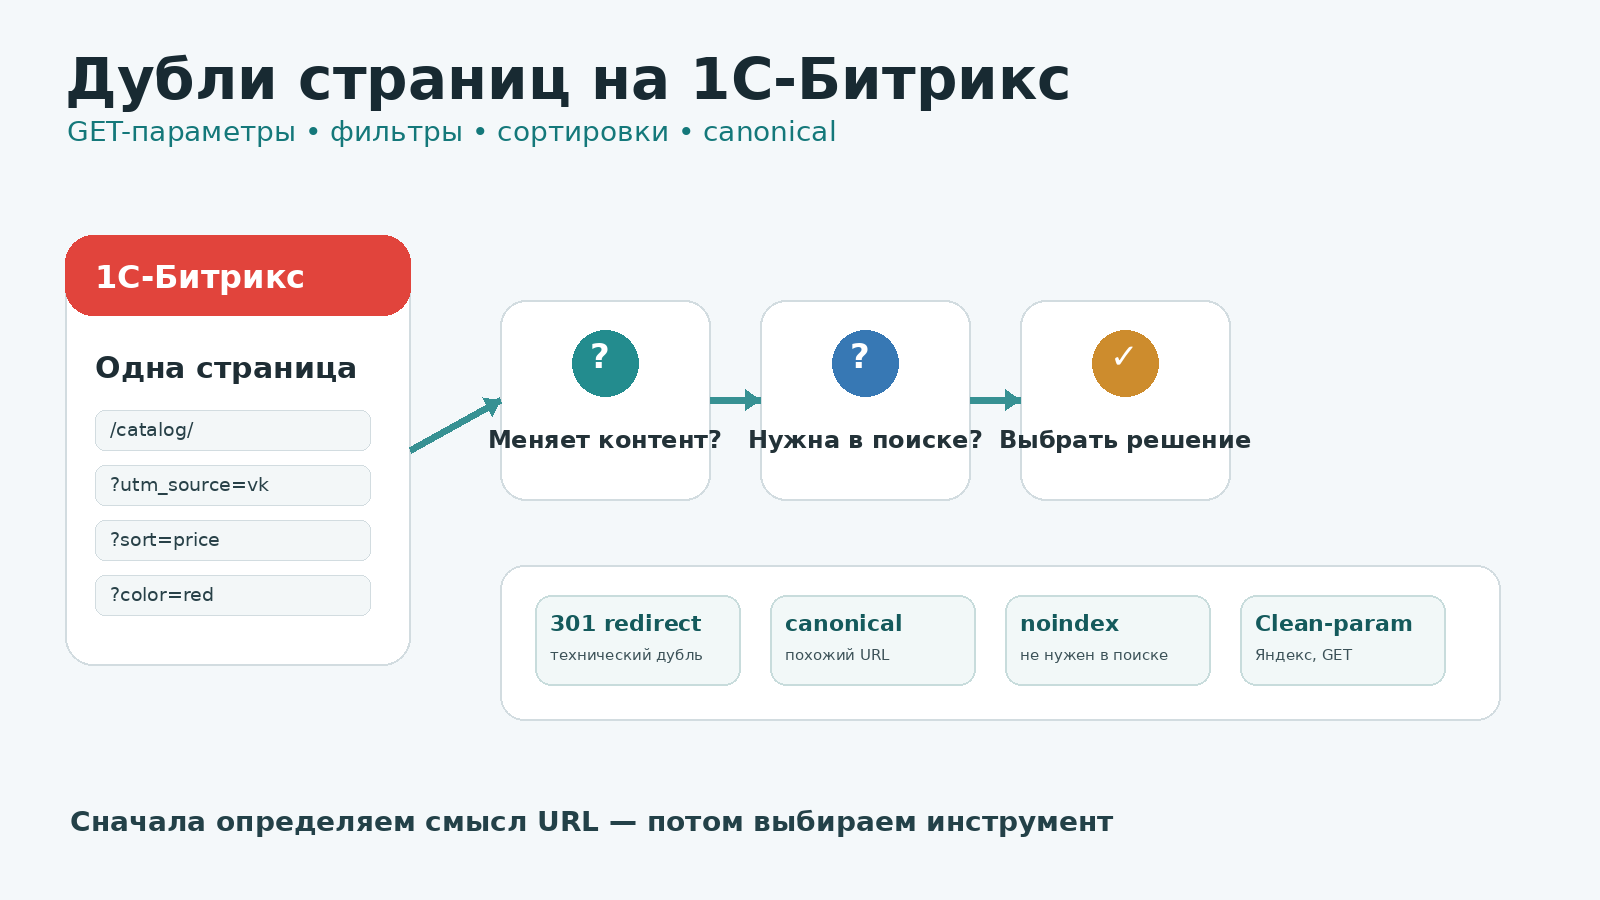
На динамическом сайте одна и та же страница легко начинает открываться по нескольким адресам.
Например:
/catalog/
/catalog/?utm_source=vk
/catalog/?sort=price
/catalog/?view=list
В браузере все четыре URL могут выглядеть почти одинаково. Но для поискового робота это четыре разных адреса, которые нужно обнаружить, обойти и обработать.
Отсюда часто появляется слишком простое решение: «закрыть от поиска все URL со знаком вопроса».
Я бы с этого не начинал.
Сам по себе GET-параметр не делает страницу плохой или дублирующей. Сначала нужно ответить на два вопроса:
-
Меняет ли параметр основное содержание страницы?
-
Должна ли получившаяся версия страницы существовать в поиске?
И только после этого выбирать техническое решение.
Что вообще считать дублем
В практическом смысле проблема возникает, когда одинаковый или практически одинаковый контент доступен по разным URL.
Например:
/catalog/
и
/catalog/?utm_source=vk
Если UTM-метка используется только для аналитики, пользователь видит тот же каталог.
Другой пример:
/catalog/?sort=price
Возможно, набор товаров тот же, но порядок изменился.
А вот:
/catalog/?color=red
может уже показывать только красные товары.
Это не означает автоматически, что такая страница должна индексироваться. Но и называть её полным дублем только из-за наличия ?color=red тоже неправильно.
Google прямо относит результаты сортировки и фильтрации к типичным источникам нескольких URL с одинаковым или близким содержанием. При этом сам факт дублирования Google не считает нарушением: задача поисковика — объединить похожие URL и выбрать канонический вариант.
Яндекс среди типичных причин дублей отдельно перечисляет особенности CMS, GET-параметры, адреса со слешем и без него, HTTP/HTTPS, www/без www и случаи, когда одна страница доступна из разных разделов.
Откуда на 1С-Битрикс берётся много URL
Здесь не всегда виновата сама CMS. Обычно складываются сразу несколько уровней: компоненты, шаблон сайта, веб-сервер, рекламная аналитика и сторонние модули.
В результате дополнительные адреса могут появляться из-за:
-
UTM-меток;
-
рекламных и аналитических параметров;
-
сортировок;
-
переключения плитки и списка;
-
пагинации;
-
фильтров каталога;
-
внутреннего поиска;
-
служебных параметров компонентов;
-
сторонних модулей;
-
доступности URL со слешем и без него;
-
/index.phpи корневого адреса; -
HTTP и HTTPS;
-
www и адреса без www;
-
одного элемента, доступного через разные разделы.
Важно: этот список — перечень мест для проверки, а не перечень того, что обязательно нужно удалить из индекса.
Например, в официальном компоненте bitrix:catalog.smart.filter предусмотрена поддержка ЧПУ через SEF_MODE и SEF_RULE. То есть фильтр на 1С-Битрикс вообще не обязан выглядеть как длинная строка GET-параметров: способ формирования URL зависит от реализации проекта.
Поэтому проблема дублей — это не проблема символа ?. Это проблема архитектуры URL и того, какие документы сайт фактически создаёт.
Незначащие GET-параметры
Самый понятный случай — параметр меняет адрес, но не меняет основной документ.
Например:
?utm_source=vk
?utm_medium=cpc
?utm_campaign=sale
?from=main
или другой tracking-параметр.
Один материал в результате может получить десятки адресов:
/services/audit/
/services/audit/?utm_source=vk
/services/audit/?utm_source=dzen
/services/audit/?from=header
Если содержимое страницы одинаковое, поисковой системе нет особого смысла хранить все эти адреса как самостоятельные документы.
Именно такие параметры Яндекс приводит в документации по GET-параметрам и Clean-param как типичный случай, когда один контент открывается по нескольким URL. Для некоторых известных аналитических параметров Яндекс даже может самостоятельно определить их как незначащие.
Но это всё равно не означает, что любой незнакомый параметр автоматически можно игнорировать. Его назначение сначала нужно проверить.
Значащие параметры — другая ситуация
Теперь возьмём каталог:
/catalog/?color=red
и
/catalog/?color=blue
Если первый URL показывает красные товары, а второй — синие, содержимое действительно меняется.
Дальше начинается уже не технический вопрос «есть GET или нет», а вопрос стратегии.
Нужна ли пользователям отдельная поисковая страница «Красные товары»?
Есть ли для неё достаточный ассортимент?
Отличается ли она от других комбинаций?
Можно ли сделать для неё нормальную посадочную страницу?
Или фильтр нужен исключительно для удобства пользователя внутри каталога?
Ответ будет разным для разных проектов.
Google в актуальной документации по фасетной навигации прямо разделяет эти сценарии. Если фильтры не нужны в поиске, можно ограничивать их обход. Если фильтруемые URL должны потенциально индексироваться, их нужно проектировать как полноценную URL-систему и учитывать, что большое количество комбинаций увеличивает объём обхода.
Поэтому правило «все фильтры закрываем» такое же неверное, как правило «все фильтры открываем».
Сортировка обычно решает другую задачу
Возьмём:
/catalog/
/catalog/?sort=price
/catalog/?sort=name
/catalog/?sort=price&order=desc
Если меняется только порядок одних и тех же товаров, пользователь получает полезную функцию интерфейса, но поисковой системе чаще всего не требуется несколько версий одного каталога только ради порядка элементов.
Google прямо приводит sorting and filtering functions как источник вариантов URL, которые могут попасть в одну группу дублей.
Но даже здесь я бы сначала посмотрел конкретную реализацию.
Например:
-
не добавляет ли сортировка другие товары;
-
не меняется ли пагинация;
-
не формируются ли внутренние ссылки на все варианты;
-
не попадают ли эти URL в Sitemap;
-
какой canonical они отдают.
Сначала выясняем, что действительно происходит, и только потом ограничиваем индексирование.
Пагинация тоже не равна дублю автоматически
Страницы:
/catalog/?PAGEN_1=2
и
/catalog/?PAGEN_1=3
могут содержать разные товары.
Поэтому механически канонизировать все страницы пагинации на первую страницу только из-за того, что URL параметризованный, нельзя без анализа содержимого и структуры каталога.
В этом и состоит главная логика всей диагностики: сравнивать документы, а не символы в адресной строке.
canonical: предпочитаемый URL среди похожих вариантов
rel="canonical" нужен, чтобы указать предпочтительный адрес среди одинаковых или очень похожих страниц.
Простейший пример:
основная страница:
https://example.ru/catalog/
вариант с аналитическим параметром:
https://example.ru/catalog/?utm_source=vk
Если содержимое одинаково и параметризованная версия должна оставаться доступной пользователю, canonical может указывать на основной URL.
canonical — не абсолютный приказ
Это важно.
Google называет canonical указанием предпочтения, но оставляет окончательный выбор за своей системой. На август 2026 года Google отдельно перечисляет силу основных способов каноникализации:
-
redirect — сильный сигнал;
-
rel="canonical"— сильный сигнал; -
наличие URL в Sitemap — слабый сигнал.
Эти методы могут использоваться согласованно. Google также учитывает особенности конфигурации сайта, в частности предпочитает корректную HTTPS-версию перед эквивалентной HTTP.
Яндекс тоже прямо называет canonical рекомендацией и предупреждает, что робот может её проигнорировать. Например, это возможно, если содержимое страниц существенно отличается, каноническая страница недоступна, указано несколько canonical или построена цепочка canonical.
То есть конструкция в HTML ещё не гарантирует, что поисковая система согласится с выбором сайта.
Self-canonical
На основной странице нормальна конструкция, в которой canonical указывает на неё саму.
Google рекомендует self-referencing canonical. Яндекс также прямо подтверждает, что указание страницы самой на себя не является ошибкой.
Это помогает сделать предпочтительную структуру URL последовательной.
Когда canonical настроен неправильно
Самые неприятные ошибки обычно выглядят не как отсутствие canonical, а как уверенно сгенерированный неправильный canonical.
Например:
карточка товара A:
/catalog/product-a/
отдаёт:
canonical → /catalog/product-b/
Или фильтр «красные товары» с реально отличающимся набором продукции канонизируется на общий каталог, хотя эту страницу планировали развивать как самостоятельную поисковую посадочную.
Ещё варианты:
-
canonical ведёт на тестовый домен;
-
HTTP-версия указывается вместо HTTPS;
-
в HTML появились два разных canonical;
-
первая страница указывает на вторую, вторая — на третью;
-
canonical формируется относительно текущего раздела и меняется для одного элемента;
-
canonical ставится на страницу с существенно другим содержанием.
Google рекомендует использовать абсолютные URL и избегать противоречивых способов каноникализации. Например, нельзя указывать один URL через rel="canonical", а другой считать основным в Sitemap.
У Яндекса несколько canonical и цепочка canonical прямо перечислены среди случаев, когда указание не учитывается.
301 redirect и canonical решают не совсем одну задачу
Допустим, страница доступна так:
/page
и
/page/
Контент одинаковый.
Если один вариант вообще не должен существовать как отдельный пользовательский адрес, логичнее устранить раздвоение на уровне URL.
В этом случае permanent redirect физически отправляет пользователя и робота на выбранный адрес.
Canonical работает иначе: альтернативный URL продолжает существовать и открываться, но сообщает предпочтительную версию.
Google рекомендует permanent redirects, когда дублирующий URL выводится из использования, и считает redirect сильным сигналом каноникализации.
Яндекс для дублей со слешем и без него прямо рекомендует HTTP 301 и отдельно пишет, что canonical в этом сценарии может быть проигнорирован. Для дубля главной через /index.php Яндекс также допускает canonical, но рекомендует redirect с внутреннего адреса на главную.
Поэтому я бы разделял ситуации так.
Когда redirect естественнее
Если альтернативный адрес больше не нужен пользователю:
-
старый URL после переноса;
-
технический
/index.php; -
одна из двух версий со слешем;
-
ненужный www-вариант;
-
прежняя версия URL после изменения структуры.
Тогда полезно сделать один реальный адрес.
Когда canonical может быть уместнее
Если альтернативный URL нужен пользователю или приложению, но является близкой копией другого документа.
Например, некоторые варианты параметризованной страницы.
Это не универсальная формула. Главное различие — остаётся ли альтернативный URL самостоятельной частью пользовательского интерфейса.
HTTP, HTTPS и www
Это тоже частый источник технических дублей.
Если сайт одновременно доступен по:
http://example.ru/page/
https://example.ru/page/
https://www.example.ru/page/
для робота это разные URL.
Google предпочитает корректную HTTPS-версию эквивалентной HTTP, но всё равно рекомендует давать согласованные сигналы, например redirect с HTTP на HTTPS и соответствующие canonical и Sitemap.
У Яндекса есть важное отличие: при переезде с HTTP на HTTPS в актуальной документации рекомендуется redirect 301/302; canonical для такого переезда больше не поддерживается как механизм смены главного адреса.
Поэтому правила Google и Яндекса здесь лучше не смешивать в одну фразу «просто поставьте canonical».
Clean-param: отдельный механизм Яндекса
Для незначащих GET-параметров у Яндекса есть специальная директива Clean-param в robots.txt.
Её задача — сообщить Яндексу, что определённый параметр не влияет на содержание страницы и при обработке URL его следует игнорировать.
Условный пример:
Clean-param: utm_source
Если:
/page/
и
/page/?utm_source=vk
показывают один и тот же документ, Яндекс может обрабатывать их как один основной адрес.
Яндекс рекомендует Clean-param именно для незначащих параметров и отмечает, что этот подход позволяет передать часть накопленных показателей основному URL.
Критически важно понимать: это механизм Яндекса.
Нельзя написать Clean-param и считать, что тем самым аналогично настроены Google и все остальные поисковые системы.
Настройка GET-параметров в Яндекс Вебмастере
На август 2026 года в Яндекс Вебмастере существует отдельный инструмент:
«Индексирование → Настройка GET-параметров».
Он показывает обнаруженные Яндексом параметры и позволяет указать, должен ли конкретный параметр учитываться при обходе и добавлении страниц в поиск.
Для параметра можно выбрать:
-
учитывать;
-
не учитывать;
-
оставить без выбранного правила.
Для добавленного вручную параметра можно также ограничить область действия — всем сайтом, главной или определённым разделом.
Есть ещё один важный нюанс.
Если настройка GET-параметров в Вебмастере конфликтует с правилом в robots.txt, Яндекс сообщает, что робот применит правило, запрещающее индексирование URL с этим параметром.
То есть при диагностике нужно проверять не только robots.txt и не только Вебмастер, а оба источника.
А где такой инструмент у Google?
Его больше нет.
В старых SEO-инструкциях до сих пор можно встретить совет открыть в Google Search Console инструмент URL Parameters и настроить там обработку sort, filter, utm и других параметров.
Эта рекомендация устарела.
Google объявил о прекращении работы URL Parameters Tool ещё весной 2022 года. Причиной стало то, что алгоритмы Google научились самостоятельно определять назначение большинства параметров, а реальную пользу давала лишь небольшая часть ручных настроек.
В актуальной Search Console для диагностики конкретного URL используется URL Inspection.
Там можно посмотреть в том числе состояние индексирования и выбранный Google canonical.
noindex и canonical — не взаимозаменяемые команды
Здесь легко смешать две разные задачи.
noindex означает:
«этот URL не должен находиться в Google Search».
Canonical означает:
«среди одинаковых или близких вариантов предпочтительным считаю этот URL».
Google прямо не рекомендует использовать noindex только для того, чтобы заставить систему выбрать другую каноническую страницу внутри сайта. Для такой задачи предпочтительнее rel="canonical".
Это не означает, что noindex нельзя применять к техническим страницам.
Просто его задача другая.
Например, если URL вообще не должен существовать в поиске как документ, noindex может быть осмысленным решением.
Если же нужно объединить сигналы нескольких одинаковых версий в один предпочтительный URL, логика canonical ближе к задаче.
robots.txt — тоже не canonical
То же относится к robots.txt.
Запрет обхода и управление дублированием — разные вещи.
Google в актуальной документации по canonical прямо рекомендует не использовать robots.txt как метод каноникализации. Заблокированный URL всё равно может быть известен Google, а содержимое страницы робот при этом не получит.
На больших каталогах есть отдельная задача экономии обхода. Например, Google рекомендует блокировать фасетные URL, если они вообще не нужны в поиске и создают огромное пространство комбинаций. Но это уже решение после определения стратегии фильтра, а не правило «запретить всё с вопросительным знаком».
Иначе легко вместе с техническими параметрами закрыть полезные SEO-фильтры.
Что должно попадать в Sitemap
Если сайт определил:
/catalog/
как основной URL, желательно последовательно придерживаться этого решения.
В Sitemap логично указывать именно канонические URL, которые владелец сайта хочет видеть в поиске.
Не нужно добавлять туда:
/catalog/?utm_source=vk
/catalog/?sort=price
/catalog/?view=list
только потому, что CMS способна открыть эти страницы.
Google официально рассматривает наличие URL в Sitemap как один из сигналов каноникализации, но называет его слабее redirect и rel="canonical".
В 1С-Битрикс штатный генератор sitemap.xml позволяет выбирать страницы, разделы и элементы инфоблоков, участвующие в генерации. Поэтому сам факт автоматической генерации не отменяет необходимость проверить результат.
Внутренние ссылки должны поддерживать выбранную архитектуру
Представим конфигурацию:
canonical:
/catalog/
Sitemap:
/catalog/
а все ссылки из меню и компонентов:
/catalog/?from=menu
Формально каждый отдельный механизм может быть настроен «правильно», но сайт постоянно создаёт противоречивые сигналы.
Google отдельно рекомендует во внутренних ссылках использовать канонический URL, а не его дублирующую версию.
Поэтому после настройки canonical я всегда считал бы важной проверку:
-
меню;
-
карточек;
-
хлебных крошек;
-
пагинации;
-
кнопок сортировки;
-
фильтра;
-
ссылок из шаблонов компонентов;
-
ссылок, создаваемых JavaScript.
Лучше предотвращать массовую генерацию ненужных URL во внутренней структуре, чем потом пытаться объяснять поисковой системе, какой из них настоящий.
Самая сложная часть — фильтры каталога
Именно здесь чаще всего нельзя дать решение одной строкой.
Фильтр способен создать:
-
полезную посадочную страницу;
-
комбинацию с минимальным спросом;
-
практически бесконечное количество комбинаций;
-
страницу без товаров;
-
несколько URL с одним набором результатов;
-
различные варианты порядка параметров.
Google называет фасетную навигацию одним из источников практически бесконечного URL-пространства. Если фильтры нужны в индексе, Google рекомендует строить их URL последовательно и возвращать корректный 404 для бессмысленных или пустых комбинаций.
Это хорошо показывает, почему стратегия «открываем весь умный фильтр» тоже опасна.
Перед технической реализацией я бы разделил фильтры хотя бы на две группы.
Фильтры, которым действительно нужна поисковая страница
Например, если комбинация:
-
имеет понятный пользовательский смысл;
-
формирует достаточно отличный ассортимент;
-
нужна как самостоятельная посадочная;
-
встроена в архитектуру сайта.
Тогда URL нужно проектировать как нормальную страницу, а не как побочный результат нажатия галочки.
Остальные комбинации
Если страница нужна только как функция интерфейса, вопрос уже состоит в том, как не создавать из неё тысячи конкурирующих поисковых документов.
И решение может включать canonical, ограничения обхода, Clean-param для Яндекса, noindex или изменение архитектуры ссылок — в зависимости от природы URL.
Практический пример seocoder.ru
На seocoder.ru задача была проще, чем у большого интернет-магазина.
Публичные URL с query string не рассматривались как самостоятельные поисковые посадочные страницы.
Для них применялась логика:
X-Robots-Tag: noindex, follow
При этом GET-URL намеренно не закрывались через robots.txt, чтобы поисковый робот мог открыть страницу и получить заголовок noindex.
Это конкретное архитектурное решение для данного сайта.
Я бы не переносил его автоматически, например, на каталог, где часть фильтров должна привлекать поисковый трафик.
Там сначала пришлось бы разделить полезные посадочные и технические комбинации, а уже потом назначать правила.
Именно поэтому тезис «у URL есть GET — ставим noindex» неверен.
Как обнаружить дубли до того, как они превратятся в хаос
Посмотреть Яндекс Вебмастер
На странице:
«Индексирование → Страницы в поиске»
можно открыть исключённые страницы и отфильтровать статус «Дубль».
Яндекс также сообщает о дублях из-за GET-параметров в диагностике сайта.
Отдельно нужно проверить «Настройку GET-параметров».
Проверить Google Search Console
Для отдельных адресов используйте URL Inspection.
Особенно полезно сравнить:
-
какой URL проверяем;
-
какой canonical заявлен сайтом;
-
какой canonical выбрал Google.
Если Google выбрал другой URL, это повод искать противоречивые сигналы или сравнивать содержимое страниц.
Обойти сайт
Поисковые панели показывают уже известную поисковикам часть проблемы.
Но чтобы найти источник, полезнее самостоятельно получить URL, которые создаёт сайт.
Особенно:
-
фильтры;
-
сортировки;
-
пагинация;
-
меню;
-
хлебные крошки;
-
карточки;
-
параметры после переходов по рекламе;
-
ссылки сторонних компонентов.
Сравнить HTML
Для двух предполагаемых дублей стоит проверить:
-
заголовок;
-
основной контент;
-
набор товаров;
-
canonical;
-
meta robots;
-
HTTP-заголовки;
-
внутренние ссылки.
Иногда два URL выглядят одинаково глазами, но технически отдают разные правила.
А иногда наоборот: URL сильно отличаются, а HTML практически идентичен.
Практический алгоритм работы с дублем
Если я нахожу несколько адресов одной страницы, порядок действий был бы таким.
-
Выписать все обнаруженные варианты URL.
-
Открыть их и сравнить фактическое содержимое.
-
Определить, какие параметры действительно меняют содержание.
-
Для каждого варианта решить: нужна ли эта страница как самостоятельный поисковый документ.
-
Выбрать основной URL для группы реальных дублей.
-
Проверить, куда ведут внутренние ссылки сайта.
-
Проверить
rel="canonical"на основном и альтернативных URL. -
Проверить Sitemap: там должны находиться согласованные предпочтительные адреса.
-
Решить, нужен ли физический permanent redirect вместо параллельного существования двух URL.
-
Для незначащих GET-параметров отдельно оценить Clean-param и «Настройку GET-параметров» Яндекс Вебмастера.
-
Для URL, которые вообще не должны индексироваться, отдельно решить вопрос noindex или ограничения обхода — в зависимости от задачи.
-
Проверить URL через Google Search Console и Яндекс Вебмастер.
-
После изменения дождаться повторного обхода и повторной обработки страниц поисковыми системами.
Последний пункт важен: исправленный canonical или redirect не переписывает поисковый индекс в момент сохранения файла.
Типичные ошибки
Поставить canonical на неправильную страницу
Особенно опасно, когда ошибка находится в общем шаблоне и распространяется сразу на весь раздел.
Вывести несколько разных canonical
Яндекс прямо указывает, что в таком случае canonical может не учитываться. Google также рекомендует не создавать противоречивые сигналы.
Закрыть полезный SEO-фильтр
Сам факт наличия параметра ещё не доказывает, что страница бесполезна.
Открыть вообще все комбинации фильтра
Получается огромное URL-пространство, значительная часть которого может не иметь самостоятельной ценности.
Размещать UTM-параметры во внутренних ссылках
В результате сайт сам постоянно создаёт дополнительные адреса вместо последовательной ссылки на основной URL.
Указать разные URL в Sitemap, canonical и внутренних ссылках
Поисковой системе приходится самой разбираться, какой сигнал считать предпочтительным.
Оставить технический дубль и надеяться только на canonical
Если второй адрес вообще не нужен пользователю, часто разумнее убрать его permanent redirect.
Решать любую проблему через robots.txt
robots.txt управляет обходом. Это не универсальный механизм каноникализации.
Пользоваться старой инструкцией по Google URL Parameters Tool
В современной Search Console такого инструмента нет: он снят с эксплуатации в 2022 году.
Главный вопрос не в GET-параметре
Если на сайте обнаружился адрес:
/catalog/?something=value
не нужно автоматически пытаться его закрыть.
Сначала выясните:
меняет ли something=value основное содержание страницы?
Если нет — перед нами один класс задачи.
Если меняет — второй вопрос:
нужна ли эта версия пользователям из поиска как самостоятельная страница?
И только после этого можно выбирать инструмент:
-
оставить URL индексируемым;
-
использовать canonical;
-
настроить permanent redirect;
-
применить noindex;
-
использовать Clean-param для Яндекса;
-
настроить GET-параметры в Яндекс Вебмастере;
-
изменить внутренние ссылки;
-
изменить саму архитектуру фильтра.
Правильное решение определяется не наличием вопросительного знака в URL, а назначением страницы.