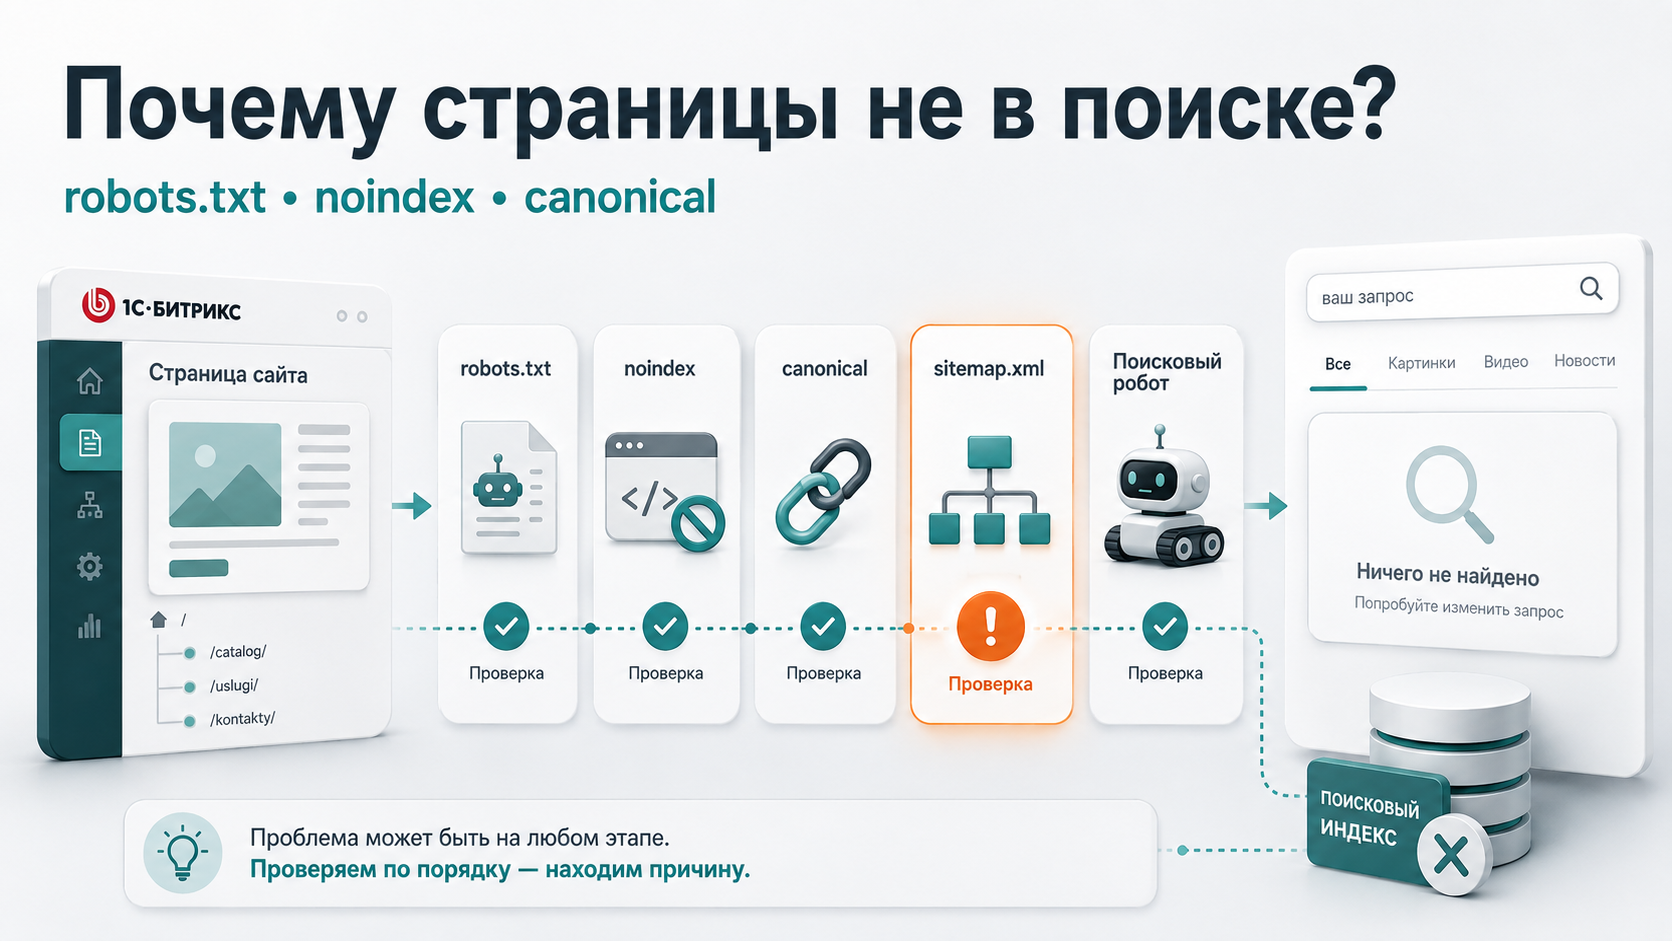
Страница существует в 1С-Битрикс, открывается по прямой ссылке, содержит текст, изображения и нормальный title. Но в Google или Яндексе её нет.
Первая реакция часто предсказуема: нужно переписать текст, добавить SEO-поля, увеличить объём контента или заняться ссылками.
Иногда проблема действительно находится в содержании страницы. Но начинать диагностику с этого рано.
Между созданием страницы в CMS и её появлением в поиске есть целая техническая цепочка:
страница существует → поисковик узнаёт URL → робот может его загрузить → индексирование разрешено → поисковик определяет канонический URL → обрабатывает страницу → решает, включать ли её в индекс и показывать ли в поиске.
Если цепочка ломается раньше, изменение текста проблему не исправит.
Сначала разделим обход и индексацию
В разговорах о SEO эти этапы часто смешивают.
Обнаружение URL
Сначала поисковая система вообще должна узнать, что адрес существует.
Источником могут быть:
-
внутренняя ссылка;
-
внешняя ссылка;
-
Sitemap;
-
ранее известный адрес;
-
другие механизмы обнаружения поисковой системы.
Если новая страница существует только внутри административной части 1С-Битрикс и на неё нигде нет ссылки, робот может узнать о ней значительно позже или не обнаружить её обычным обходом сайта.
Обход страницы
Следующий этап — crawling.
Робот запрашивает URL у сервера. На этом этапе имеют значение robots.txt, доступность сервера, HTTP-ответ, редиректы и другие технические условия.
Индексирование
Если страницу удалось получить, поисковая система анализирует её и решает, может и должна ли она попасть в индекс.
Здесь уже имеют значение noindex, canonical, дублирование и другие сигналы.
Даже успешный HTTP-ответ 200 не гарантирует индексирование: Google прямо указывает, что содержимое страницы в таком случае передаётся на дальнейшую обработку, но включение в индекс не обещается.
Появление в результатах поиска
Наличие страницы в индексе и её фактический показ по конкретному запросу — тоже не одно и то же.
Поэтому фраза «страница не находится в поиске» требует уточнения: робот её не видел, не смог загрузить, не проиндексировал или страница проиндексирована, но не показывается по ожидаемому запросу.
robots.txt: запрет обхода — не кнопка удаления из поиска
robots.txt в первую очередь управляет тем, какие URL разрешено запрашивать поисковым роботам.
Это важное различие.
Google прямо предупреждает: URL, закрытый через robots.txt, всё равно может появиться в результатах поиска, если Google узнал о нём, например, по внешним ссылкам. При этом содержимое страницы робот не сможет нормально получить, поэтому результат может отображаться без обычного описания.
У Яндекса позиция похожая: в актуальной документации отдельно сказано, что страницы, ограниченные через robots.txt, могут участвовать в поиске. Для запрета индексирования Яндекс рекомендует использовать noindex в HTML или HTTP-заголовке и не закрывать такую страницу от робота, иначе он не сможет увидеть инструкцию.
Отсюда практический вывод:
Disallow в robots.txt и запрет индексирования страницы — не одно и то же действие.
Перед поиском более сложной причины нужно проверить, не попал ли нужный раздел под слишком широкое правило Disallow.
Особенно после:
-
разработки новой версии сайта;
-
переноса;
-
изменения структуры;
-
установки готового решения;
-
ручного редактирования robots.txt.
noindex: когда страница доступна роботу, но не должна быть в поиске
Для запрета индексирования можно использовать директиву noindex.
Для HTML-страницы распространённый вариант — meta robots.
Если управление удобнее выполнять на уровне ответа сервера либо речь идёт не только об HTML, применяется X-Robots-Tag.
Google официально поддерживает оба варианта. Для HTML они могут решать одну и ту же задачу, а X-Robots-Tag дополнительно подходит для ресурсов, где HTML-метатег использовать невозможно, например PDF.
Яндекс также поддерживает noindex через robots meta и X-Robots-Tag.
Почему robots.txt и noindex могут конфликтовать
Допустим, разработчик сделал одновременно две вещи:
-
запретил URL в robots.txt;
-
добавил на эту страницу noindex.
На первый взгляд кажется, что запрет стал надёжнее.
На практике поисковый робот может вообще не загрузить страницу из-за robots.txt и, соответственно, не увидеть noindex.
Google отдельно предупреждает об этом: для действия noindex страница должна оставаться доступной для обхода.
Яндекс в актуальной документации даёт аналогичную рекомендацию.
Поэтому механическое сочетание двух запретов без понимания задачи — плохая практика.
Отдельная проблема — URL с GET-параметрами
На сайтах легко появляются адреса вроде:
/catalog/?sort=price
/catalog/?utm_source=...
/services/?foo=bar
Один и тот же контент при этом может быть доступен по множеству URL.
Но отсюда не следует правило «все GET-параметры нужно запрещать».
Сначала нужно понять, что именно делает параметр.
Служебные и аналитические параметры
Например, UTM-метки обычно не создают новую полезную страницу. Они изменяют URL ради аналитики, но содержимое остаётся тем же.
Яндекс отдельно умеет работать с такими случаями: в Вебмастере существует настройка GET-параметров, а также поддерживается Clean-param. В документации Яндекса прямо приводятся аналитические параметры вроде utm_source как пример параметров, которые могут создавать дубли.
Сортировки
URL вида ?sort=price обычно меняет порядок уже существующих элементов.
Такой адрес необязательно должен становиться отдельной поисковой страницей.
Фильтры
Здесь всё сложнее.
Некоторые фильтры создают большое количество технических комбинаций, которые не нужны в поиске. Google отдельно предупреждает, что параметризованная фасетная навигация способна создавать практически неограниченное пространство URL и тратить ресурсы обхода.
Но на другом проекте отдельные фильтры могут быть полноценными посадочными страницами с самостоятельной ценностью.
Поэтому запрещать вообще все URL с вопросительным знаком — слишком грубое решение.
Как это сделано на seocoder.ru
На seocoder.ru для публичных URL с query string использовался конкретный архитектурный вариант:
X-Robots-Tag: noindex, follow
При этом такие GET-адреса намеренно не блокировались через robots.txt.
Логика была простой: робот должен иметь возможность открыть URL и получить HTTP-заголовок с noindex.
Это подходит для выбранной структуры seocoder.ru, но я бы не переносил такое правило автоматически на любой интернет-магазин или каталог.
Если фильтры должны участвовать в поиске, архитектура будет другой.
Проверьте HTTP-ответ, а не только страницу в браузере
Владелец сайта открывает страницу и видит нормальный экран. Кажется, что с URL всё в порядке.
Но поисковый робот работает с ответом сервера.
Для страницы, которую предполагается индексировать, первым делом нужно посмотреть фактический HTTP-код.
200
Обычный успешный ответ.
Но, как уже отмечалось выше, для Google 200 означает возможность передать содержимое дальше на обработку, а не обещание индексирования.
3xx
URL перенаправляет робота на другой адрес.
Если вы проверяете старую страницу, которая уже отдаёт 301 на новую, ожидать индексирования именно старого URL обычно бессмысленно.
Отдельно стоит избегать ненужных цепочек:
страница A → страница B → страница C → страница D.
404
Страница сообщает, что ресурс не найден.
Google не индексирует URL, возвращающие обычные 4xx-ответы.
5xx
Это серверные ошибки.
Если они возникают регулярно, робот может не получить страницу. Google также снижает интенсивность обхода при значительном количестве серверных ошибок.
В Яндекс Вебмастере для диагностики существует отдельный инструмент «Проверка ответа сервера», который показывает доступность страницы роботу и полученный HTTP-ответ.
canonical: какой из нескольких URL считать основным
Теперь допустим, что страницу можно обнаружить, робот её загружает, noindex отсутствует и сервер отвечает корректно.
Следующий вопрос — не считает ли поисковик этот URL дублем другой страницы.
Для этого используется в том числе rel="canonical".
Типичные ситуации:
-
одинаковый контент открывается с параметром и без него;
-
страница доступна по нескольким вариантам URL;
-
canonical случайно ведёт на другую карточку;
-
canonical остался от тестового домена;
-
разные компоненты сформировали несколько canonical;
-
возникла цепочка канонических адресов.
Google воспринимает canonical как сигнал, а не безусловный приказ
Google прямо пишет, что владелец сайта указывает предпочтительную каноническую версию, но сама система может выбрать другой URL.
Среди сигналов Google использует redirects, rel="canonical", наличие URL в Sitemap и другие факторы. При этом Sitemap является более слабым сигналом, чем rel="canonical".
Google также рекомендует использовать абсолютный URL в rel="canonical" и по возможности ставить self-referencing canonical на саму каноническую страницу.
Отсутствие canonical само по себе не означает, что страница обязательно пропадёт из Google: если явного указания нет, Google может определить каноническую версию самостоятельно.
У Яндекса есть свои условия
Яндекс также поддерживает rel="canonical", но может не принять указание, например если содержимое страниц существенно различается или выбранный канонический URL недоступен роботу.
В актуальной документации Яндекса отдельно указано, что canonical не учитывается при нескольких канонических URL и при цепочке canonical.
Поэтому canonical нужно не просто «наличествовать в коде», а проверять на конкретном URL.
Sitemap помогает обнаруживать страницы, но не индексирует их
Одна из самых частых ошибок выглядит так:
Страница есть в sitemap.xml, значит поисковик обязан её добавить.
Нет.
Google определяет Sitemap как способ помочь поисковой системе обнаружить URL и прямо предупреждает, что наличие адреса в Sitemap не гарантирует ни обход, ни индексирование.
Google также рекомендует включать туда именно URL, которые вы хотите видеть в поиске, и использовать предпочтительные канонические версии.
Яндекс рекомендует включать в Sitemap значимые URL и отдельно требует, чтобы сам файл был доступен роботу с HTTP 200.
Поэтому странно одновременно:
-
ставить странице noindex;
-
считать её неканонической;
-
и продолжать отправлять её в Sitemap как важный URL.
Это противоречивые сигналы.
Что относится непосредственно к 1С-Битрикс
В «1С-Битрикс: Управление сайтом» есть штатный механизм генерации sitemap.xml. В официальной документации управление им находится в разделе поисковой оптимизации, где можно задавать, какие страницы и элементы инфоблоков участвуют в генерации.
На seocoder.ru Sitemap также генерировался штатным механизмом 1С-Битрикс, а robots.txt содержал ссылку на него.
Но даже штатно созданный файл нужно проверять.
На давно не обслуживаемом сайте я бы вообще не начинал восстановление структуры исключительно с robots.txt и sitemap.xml.
Они полезны, но тоже могут быть устаревшими.
Их нужно сравнивать с реальным публичным сайтом, меню, разделами, внутренними ссылками и доступными URL.
Если на страницу нет внутренних ссылок
В 1С-Битрикс элемент может прекрасно существовать в инфоблоке.
У него может быть:
-
символьный код;
-
ЧПУ;
-
детальная страница;
-
корректный HTTP 200.
Но если эта страница никак нормально не встроена в публичную структуру, её обнаружение становится сложнее.
Стоит проверить:
-
ведёт ли на неё раздел;
-
присутствует ли она в каталоге;
-
есть ли ссылка из меню, если это соответствует структуре;
-
участвует ли в хлебных крошках;
-
есть ли контекстные ссылки с других материалов;
-
можно ли вообще дойти до неё обычной навигацией от главной.
Google прямо рекомендует, чтобы каждая важная страница имела ссылку хотя бы с одной другой страницы сайта. Ссылки используются в том числе для обнаружения новых URL.
Sitemap здесь полезен, но не должен заменять нормальную архитектуру сайта.
Что смотреть в Google Search Console
Когда базовые проверки выполнены, имеет смысл посмотреть не предположения, а информацию самого Google.
URL Inspection
Для конкретного URL это один из самых полезных инструментов.
Он показывает, например:
-
знает ли Google страницу;
-
удалось ли её получить;
-
разрешён ли обход;
-
разрешено ли индексирование;
-
какой canonical выбрал Google;
-
когда страницу обходили в последний раз.
Также можно запустить проверку актуальной версии URL и после исправления запросить индексирование.
Важно: запрос индексирования не является гарантией включения страницы в индекс.
Page indexing
Отчёт об индексировании страниц помогает увидеть общую картину: какие известные Google URL проиндексированы, а какие нет и по какой причине.
Google отдельно напоминает, что цель не состоит в достижении 100% индексации всех известных URL: технические дубли, варианты фильтров и другие страницы могут обоснованно не индексироваться.
Sitemaps
Здесь можно проверить, смог ли Google получить отправленный Sitemap и использовать его как источник URL.
Что смотреть в Яндекс Вебмастере
У Яндекса набор инструментов немного другой, поэтому не стоит механически переносить названия из Google Search Console.
Для конкретной страницы полезна «Проверка страницы».
Для технической доступности — «Проверка ответа сервера».
В разделе «Индексирование → Страницы в поиске» можно увидеть как участвующие в поиске URL, так и исключённые страницы с причиной исключения. Среди статусов сейчас встречаются, например:
-
HTTP-ошибка;
-
запрет noindex;
-
дубль;
-
неканоническая страница.
После исправлений доступен инструмент «Переобход страниц».
Отдельно в Вебмастере контролируются файлы Sitemap.
Почему исправленная страница не появляется мгновенно
Предположим, вчера вы:
-
исправили robots.txt;
-
удалили ошибочный noindex;
-
поменяли canonical;
-
обновили Sitemap;
-
добавили внутреннюю ссылку.
Сегодня поисковая система всё ещё может показывать старое состояние.
Это не обязательно означает, что исправление не сработало.
Робот должен повторно получить URL, а поисковой системе нужно обработать новые данные.
Google прямо указывает в URL Inspection дату последнего обхода и позволяет отдельно проверить текущую live-версию страницы. Если изменения сделаны после последнего обхода, информация в индексе ещё может отражать старое состояние.
У Яндекса в «Страницах в поиске» также отображается дата последнего посещения роботом, а после исправления страницу можно отправить на переобход.
Точный срок обещать нельзя.
Технически исправить страницу и дождаться обновления поискового индекса — два разных этапа.
Практический алгоритм: почему конкретной страницы нет в поиске
Когда мне нужно разобраться с одним URL, я бы шёл в таком порядке.
-
Открыть именно тот URL, который должен индексироваться, а не похожую страницу.
-
Проверить фактический HTTP-ответ сервера.
-
Проверить, не запрещён ли URL правилами robots.txt.
-
Посмотреть HTML и HTTP-заголовки: нет ли meta robots noindex или X-Robots-Tag: noindex.
-
Проверить rel="canonical": куда он ведёт и совпадает ли это с логикой страницы.
-
Проверить редиректы и убедиться, что URL не отправляет робота на другой адрес.
-
Найти внутреннюю ссылку на страницу и понять, встроена ли она в реальную публичную структуру сайта.
-
Решить, должна ли именно эта каноническая страница присутствовать в sitemap.xml, и проверить актуальность файла.
-
Проверить URL через Google Search Console → URL Inspection и посмотреть последнюю известную Google версию страницы.
-
Проверить страницу в Яндекс Вебмастере, её HTTP-ответ и причину исключения, если URL известен Яндексу.
-
Сравнить дату последнего обхода с датой внесённых изменений. Если робот ещё не видел исправленную версию, сначала нужен переобход, а не новая переделка страницы.
Только после прохождения этой цепочки имеет смысл переходить к вопросу о качестве и востребованности самого содержимого страницы.
Две ошибки, которые особенно легко допустить
Страница есть в Sitemap, поэтому поисковик обязан её индексировать.
Sitemap сообщает о URL и помогает его обнаружить. Решение об индексировании остаётся за поисковой системой. Google говорит об этом прямо.
И обратное утверждение:
Я закрыл URL через robots.txt, значит он точно исчезнет из поиска.
Это тоже неверно. И Google, и Яндекс допускают появление известного URL в поиске даже при ограничении обхода через robots.txt.
Где искать проблему в первую очередь
Когда страница отсутствует в поиске, сначала нужно определить, на каком этапе нарушилась цепочка.
Поисковик не обнаружил URL?
Робот не может его загрузить?
Страница закрыта от индексирования?
Canonical указывает на другой адрес?
Поисковик считает страницу дублем?
Или технические ошибки уже исправлены, но робот пока не видел новую версию?
Ответ на эти вопросы обычно полезнее, чем немедленное переписывание текста или попытка «усилить SEO» страницы, до которой поисковая система технически ещё не добралась.